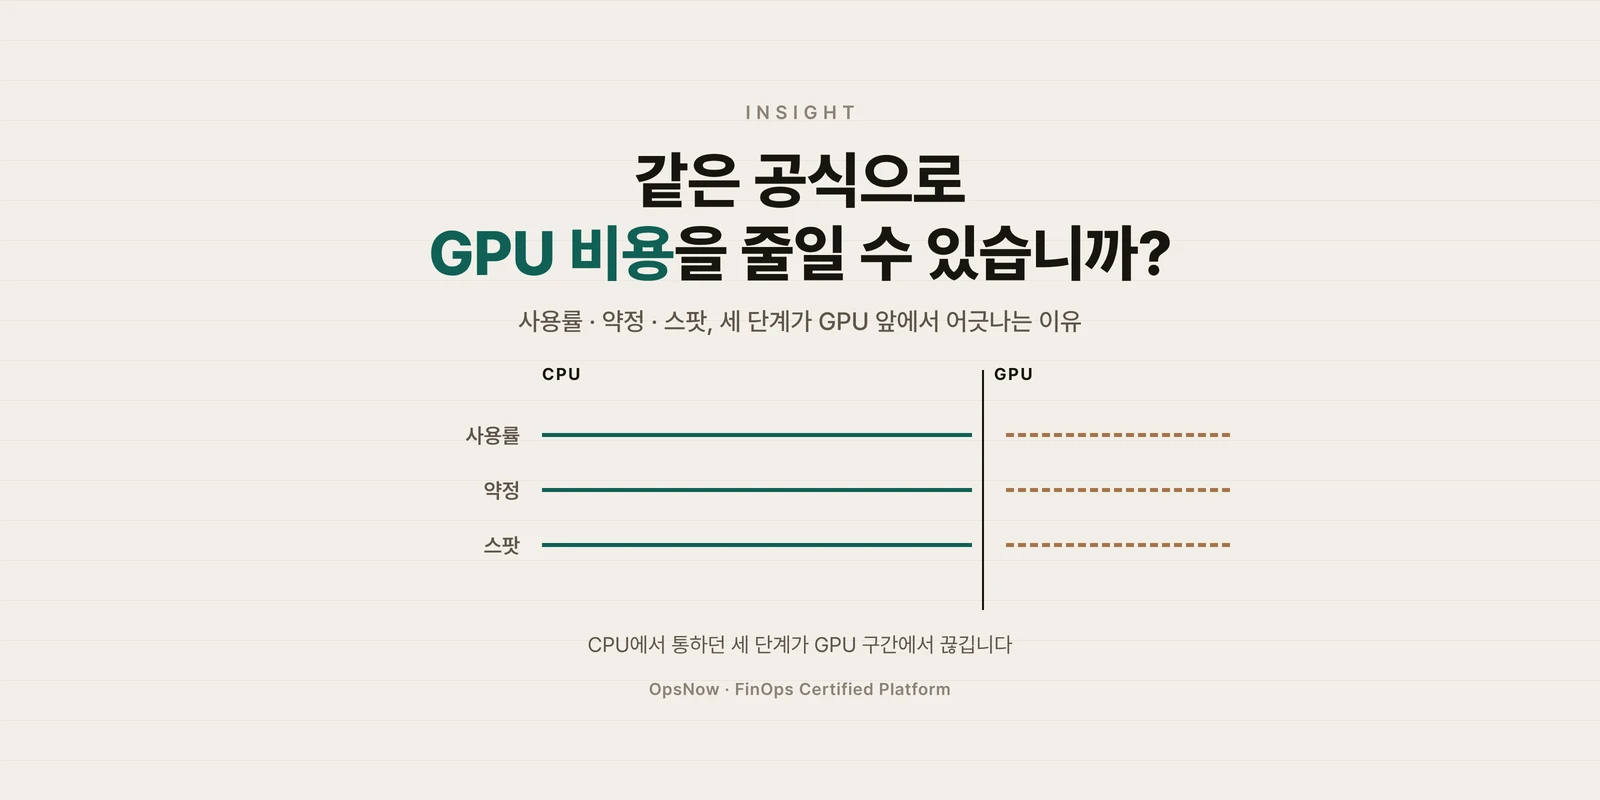
■ 문제: GPU 인스턴스에 기존 최적화 공식(사용률로 줄이고, 기본량은 약정, 나머지는 스팟)을 그대로 대면 판단 근거부터 어긋납니다.
■ 해결: GPU 사용률 지표를 먼저 모으고, 용량을 확보하는 비용과 실제로 쓰는 비용을 나눠 보고, 학습과 추론에 다른 수단을 고릅니다.
■ 효과: CPU 그래프로 짐작하던 GPU 워크로드 비용을 GPU 지표와 예약 사용 내역으로 판단하게 됩니다.
월요일 비용 점검 회의. GPU 인스턴스 요금이 지난달보다 크게 늘었는데, 화면에 띄운 모니터링 대시보드의 CPU 그래프는 바닥에 붙어 있었습니다. 줄여도 되는 걸까요, 아니면 GPU는 쉴 새 없이 돌고 있었던 걸까요. 그 자리에서 아무도 답하지 못했습니다.
GPU 워크로드 비용이 어려운 이유는 금액보다 공식에 있습니다. 클라우드 비용 최적화의 익숙한 순서 세 가지가 GPU 앞에서 하나씩 어긋납니다.
라이트사이징은 사용률 지표에서 출발합니다. AWS CloudWatch 문서에 따르면 NVIDIA GPU 지표는 CloudWatch 에이전트 설정 파일에 nvidia_gpu 구간을 추가해야 수집되고, 인스턴스에 NVIDIA 드라이버도 있어야 합니다. 설정하지 않은 계정에서는 CPU 그래프만 보고 GPU 인스턴스를 판단하게 됩니다.
지표를 켠 뒤에도 읽는 법이 다릅니다. 같은 문서는 utilization_gpu를 "지난 샘플 기간 중 GPU에서 커널이 하나 이상 실행된 시간의 비율"로 정의합니다. 얼마나 꽉 채워 썼는지가 아니라 돌고 있던 시간의 비율입니다.
CPU 인스턴스라면 꾸준히 쓰는 양에 Savings Plans를 걸면 됩니다. GPU는 쓰기 전에 자리를 잡는 일부터 비용입니다.
AWS EC2 문서 기준으로 Capacity Blocks for ML은 예약하는 시점에 요금을 선불로 내고, 가격은 구매 시점의 수요와 공급에 따라 정해집니다. Savings Plans와 RI 할인은 적용되지 않습니다. 온디맨드 용량 예약(Capacity Reservation)은 인스턴스를 띄우든 안 띄우든 온디맨드 요금이 청구되고, 쓰지 않은 몫은 청구서에 미사용 예약으로 남습니다.
스팟 인스턴스는 회수되기 2분 전에 중단 알림을 받습니다(AWS EC2 문서). 짧은 추론 요청이라면 다른 인스턴스로 넘기면 됩니다. 며칠씩 도는 학습 작업은 다릅니다. 중간 상태를 저장하는 체크포인트가 없으면 회수되는 순간 그때까지의 연산이 사라집니다.
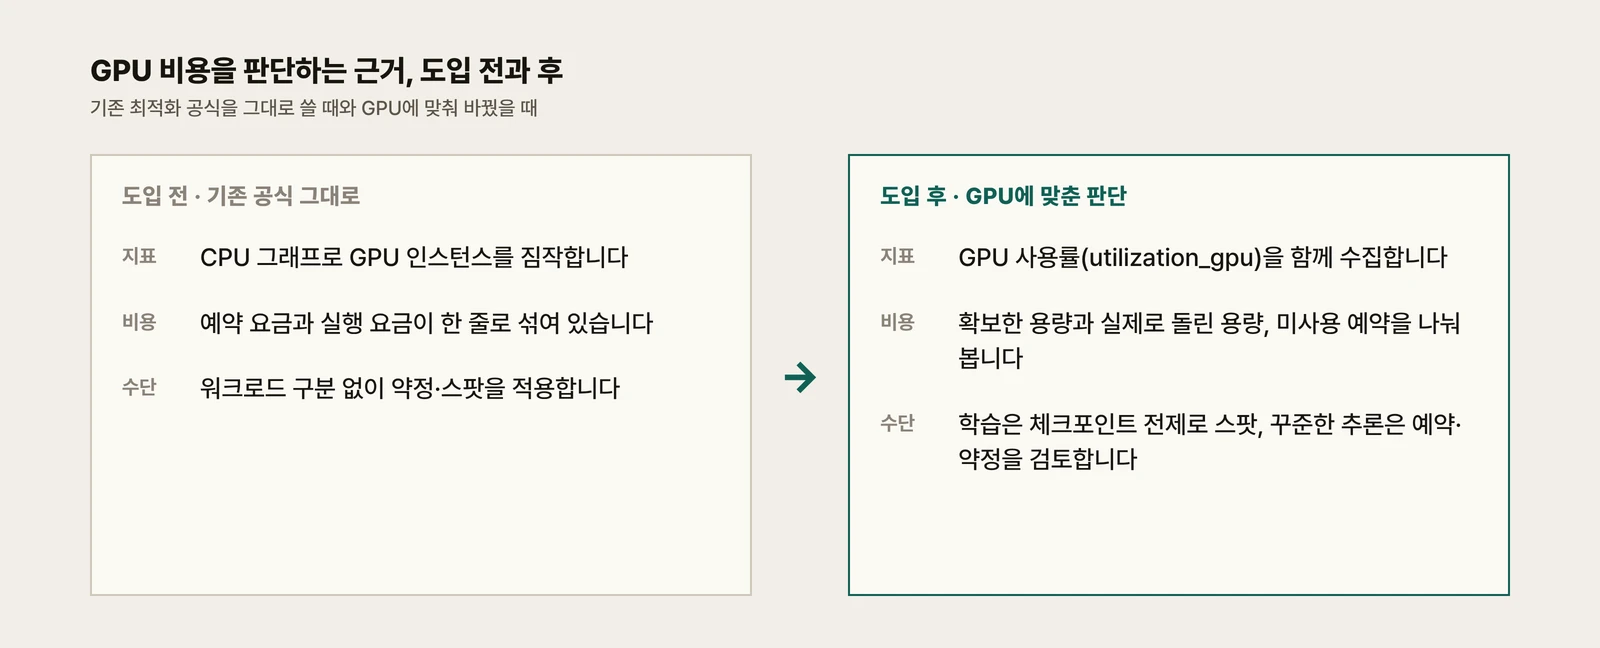
바꾸기 전에는 월말 청구서에서 GPU 인스턴스 금액이 튀면 CPU 그래프를 열어 봅니다. 예약 요금과 실행 요금이 한 줄로 섞여 있어 어디서 늘었는지 가르기 어렵습니다.
바꾼 뒤에는 GPU 지표가 함께 쌓여 있어, 같은 담당자가 사용률과 미사용 예약을 나란히 놓고 봅니다. 학습은 체크포인트를 전제로 스팟을, 꾸준한 추론은 예약이나 약정을 검토하는 식으로 워크로드마다 수단이 갈립니다.
월요일 회의의 그 질문으로 돌아가면, 답은 그래프 하나를 더 켜는 데서 나옵니다. 줄일지 말지는 그다음입니다.
아닙니다. AWS 문서에 따르면 CloudWatch 에이전트 설정에 nvidia_gpu 구간을 추가해야 수집되고, 인스턴스에 NVIDIA 드라이버가 설치돼 있어야 합니다.
예약 방식에 따라 다릅니다. AWS 문서는 Capacity Blocks for ML에 Savings Plans와 RI 할인이 적용되지 않는다고 밝힙니다. 어떤 방식으로 GPU를 확보했는지부터 확인해야 합니다.
체크포인트가 있다면 검토할 만합니다. 스팟은 회수 2분 전에 알림이 오므로, 중간 상태를 저장해 두지 않은 긴 학습 작업은 회수될 때 진행분을 잃습니다.

■ 문제: GPU 인스턴스에 기존 최적화 공식(사용률로 줄이고, 기본량은 약정, 나머지는 스팟)을 그대로 대면 판단 근거부터 어긋납니다.
■ 해결: GPU 사용률 지표를 먼저 모으고, 용량을 확보하는 비용과 실제로 쓰는 비용을 나눠 보고, 학습과 추론에 다른 수단을 고릅니다.
■ 효과: CPU 그래프로 짐작하던 GPU 워크로드 비용을 GPU 지표와 예약 사용 내역으로 판단하게 됩니다.
월요일 비용 점검 회의. GPU 인스턴스 요금이 지난달보다 크게 늘었는데, 화면에 띄운 모니터링 대시보드의 CPU 그래프는 바닥에 붙어 있었습니다. 줄여도 되는 걸까요, 아니면 GPU는 쉴 새 없이 돌고 있었던 걸까요. 그 자리에서 아무도 답하지 못했습니다.
GPU 워크로드 비용이 어려운 이유는 금액보다 공식에 있습니다. 클라우드 비용 최적화의 익숙한 순서 세 가지가 GPU 앞에서 하나씩 어긋납니다.
라이트사이징은 사용률 지표에서 출발합니다. AWS CloudWatch 문서에 따르면 NVIDIA GPU 지표는 CloudWatch 에이전트 설정 파일에 nvidia_gpu 구간을 추가해야 수집되고, 인스턴스에 NVIDIA 드라이버도 있어야 합니다. 설정하지 않은 계정에서는 CPU 그래프만 보고 GPU 인스턴스를 판단하게 됩니다.
지표를 켠 뒤에도 읽는 법이 다릅니다. 같은 문서는 utilization_gpu를 "지난 샘플 기간 중 GPU에서 커널이 하나 이상 실행된 시간의 비율"로 정의합니다. 얼마나 꽉 채워 썼는지가 아니라 돌고 있던 시간의 비율입니다.
CPU 인스턴스라면 꾸준히 쓰는 양에 Savings Plans를 걸면 됩니다. GPU는 쓰기 전에 자리를 잡는 일부터 비용입니다.
AWS EC2 문서 기준으로 Capacity Blocks for ML은 예약하는 시점에 요금을 선불로 내고, 가격은 구매 시점의 수요와 공급에 따라 정해집니다. Savings Plans와 RI 할인은 적용되지 않습니다. 온디맨드 용량 예약(Capacity Reservation)은 인스턴스를 띄우든 안 띄우든 온디맨드 요금이 청구되고, 쓰지 않은 몫은 청구서에 미사용 예약으로 남습니다.
스팟 인스턴스는 회수되기 2분 전에 중단 알림을 받습니다(AWS EC2 문서). 짧은 추론 요청이라면 다른 인스턴스로 넘기면 됩니다. 며칠씩 도는 학습 작업은 다릅니다. 중간 상태를 저장하는 체크포인트가 없으면 회수되는 순간 그때까지의 연산이 사라집니다.
바꾸기 전에는 월말 청구서에서 GPU 인스턴스 금액이 튀면 CPU 그래프를 열어 봅니다. 예약 요금과 실행 요금이 한 줄로 섞여 있어 어디서 늘었는지 가르기 어렵습니다.
바꾼 뒤에는 GPU 지표가 함께 쌓여 있어, 같은 담당자가 사용률과 미사용 예약을 나란히 놓고 봅니다. 학습은 체크포인트를 전제로 스팟을, 꾸준한 추론은 예약이나 약정을 검토하는 식으로 워크로드마다 수단이 갈립니다.

월요일 회의의 그 질문으로 돌아가면, 답은 그래프 하나를 더 켜는 데서 나옵니다. 줄일지 말지는 그다음입니다.
아닙니다. AWS 문서에 따르면 CloudWatch 에이전트 설정에 nvidia_gpu 구간을 추가해야 수집되고, 인스턴스에 NVIDIA 드라이버가 설치돼 있어야 합니다.
예약 방식에 따라 다릅니다. AWS 문서는 Capacity Blocks for ML에 Savings Plans와 RI 할인이 적용되지 않는다고 밝힙니다. 어떤 방식으로 GPU를 확보했는지부터 확인해야 합니다.
체크포인트가 있다면 검토할 만합니다. 스팟은 회수 2분 전에 알림이 오므로, 중간 상태를 저장해 두지 않은 긴 학습 작업은 회수될 때 진행분을 잃습니다.
■ 문제: GPU 인스턴스에 기존 최적화 공식(사용률로 줄이고, 기본량은 약정, 나머지는 스팟)을 그대로 대면 판단 근거부터 어긋납니다.
■ 해결: GPU 사용률 지표를 먼저 모으고, 용량을 확보하는 비용과 실제로 쓰는 비용을 나눠 보고, 학습과 추론에 다른 수단을 고릅니다.
■ 효과: CPU 그래프로 짐작하던 GPU 워크로드 비용을 GPU 지표와 예약 사용 내역으로 판단하게 됩니다.
월요일 비용 점검 회의. GPU 인스턴스 요금이 지난달보다 크게 늘었는데, 화면에 띄운 모니터링 대시보드의 CPU 그래프는 바닥에 붙어 있었습니다. 줄여도 되는 걸까요, 아니면 GPU는 쉴 새 없이 돌고 있었던 걸까요. 그 자리에서 아무도 답하지 못했습니다.
GPU 워크로드 비용이 어려운 이유는 금액보다 공식에 있습니다. 클라우드 비용 최적화의 익숙한 순서 세 가지가 GPU 앞에서 하나씩 어긋납니다.
라이트사이징은 사용률 지표에서 출발합니다. AWS CloudWatch 문서에 따르면 NVIDIA GPU 지표는 CloudWatch 에이전트 설정 파일에 nvidia_gpu 구간을 추가해야 수집되고, 인스턴스에 NVIDIA 드라이버도 있어야 합니다. 설정하지 않은 계정에서는 CPU 그래프만 보고 GPU 인스턴스를 판단하게 됩니다.
지표를 켠 뒤에도 읽는 법이 다릅니다. 같은 문서는 utilization_gpu를 "지난 샘플 기간 중 GPU에서 커널이 하나 이상 실행된 시간의 비율"로 정의합니다. 얼마나 꽉 채워 썼는지가 아니라 돌고 있던 시간의 비율입니다.
CPU 인스턴스라면 꾸준히 쓰는 양에 Savings Plans를 걸면 됩니다. GPU는 쓰기 전에 자리를 잡는 일부터 비용입니다.
AWS EC2 문서 기준으로 Capacity Blocks for ML은 예약하는 시점에 요금을 선불로 내고, 가격은 구매 시점의 수요와 공급에 따라 정해집니다. Savings Plans와 RI 할인은 적용되지 않습니다. 온디맨드 용량 예약(Capacity Reservation)은 인스턴스를 띄우든 안 띄우든 온디맨드 요금이 청구되고, 쓰지 않은 몫은 청구서에 미사용 예약으로 남습니다.
스팟 인스턴스는 회수되기 2분 전에 중단 알림을 받습니다(AWS EC2 문서). 짧은 추론 요청이라면 다른 인스턴스로 넘기면 됩니다. 며칠씩 도는 학습 작업은 다릅니다. 중간 상태를 저장하는 체크포인트가 없으면 회수되는 순간 그때까지의 연산이 사라집니다.
바꾸기 전에는 월말 청구서에서 GPU 인스턴스 금액이 튀면 CPU 그래프를 열어 봅니다. 예약 요금과 실행 요금이 한 줄로 섞여 있어 어디서 늘었는지 가르기 어렵습니다.
바꾼 뒤에는 GPU 지표가 함께 쌓여 있어, 같은 담당자가 사용률과 미사용 예약을 나란히 놓고 봅니다. 학습은 체크포인트를 전제로 스팟을, 꾸준한 추론은 예약이나 약정을 검토하는 식으로 워크로드마다 수단이 갈립니다.

월요일 회의의 그 질문으로 돌아가면, 답은 그래프 하나를 더 켜는 데서 나옵니다. 줄일지 말지는 그다음입니다.
아닙니다. AWS 문서에 따르면 CloudWatch 에이전트 설정에 nvidia_gpu 구간을 추가해야 수집되고, 인스턴스에 NVIDIA 드라이버가 설치돼 있어야 합니다.
예약 방식에 따라 다릅니다. AWS 문서는 Capacity Blocks for ML에 Savings Plans와 RI 할인이 적용되지 않는다고 밝힙니다. 어떤 방식으로 GPU를 확보했는지부터 확인해야 합니다.
체크포인트가 있다면 검토할 만합니다. 스팟은 회수 2분 전에 알림이 오므로, 중간 상태를 저장해 두지 않은 긴 학습 작업은 회수될 때 진행분을 잃습니다.